 Nicolas Sacotte
So funktioniert Ranktracking – und warum es so verwundbar ist
Das Prinzip hinter klassischem Ranktracking ist simpel. Ein Scraper schickt ein Keyword an die Google-Suche, lädt die Ergebnisseite und liest den Quelltext aus. Aus den Links und Snippets ergibt sich, welche URL auf welcher Position steht. Wiederholt für tausende Keywords, Standorte und Endgeräte, entstehen daraus Rankingverläufe, Sichtbarkeitsindizes und Wettbewerbsvergleiche.
Damit das im großen Stil funktioniert, brauchen Tool-Anbieter drei Dinge:
Zugang: Anfragen müssen wie echte Nutzer aussehen. Dafür laufen sie über sogenannte Residential Proxies, also Netzwerke aus privaten IP-Adressen.
Effizienz: Je weniger Requests pro Keyword nötig sind, desto günstiger die Daten.
Lesbarkeit: Der Quelltext muss die Ziel-URLs und Snippets maschinenlesbar enthalten.
Google hat in den vergangenen 20 Monaten an allen drei Punkten angesetzt. Eine offizielle Alternative gibt es nicht: Die Custom Search JSON API ist bereits für Neukunden geschlossen und wird laut Google zum 1. Januar 2027 abgeschaltet. Der empfohlene Nachfolger Vertex AI Search ist eine Enterprise-Suche für eigene Inhalte und liefert keine öffentlichen SERP-Daten.
Chronologie: Wie Google die Daumenschrauben angezogen hat
Einzeln betrachtet wirkte jede Maßnahme wie eine technische Randnotiz. In der Summe ergibt sich ein klares Muster:
Datum | Maßnahme | Folge für Ranktracker |
|---|---|---|
Januar 2025 | JavaScript-Pflicht für die Suche, intern „SearchGuard“ | Einfache HTTP-Requests reichen nicht mehr, es braucht echte Browser-Sessions |
ca. 10.–14.09.2025 | Zehn Requests statt einem für die Top 100 | |
19.12.2025 | Rechtsunsicherheit für die gesamte Branche | |
02.07.2026 | Abschaltung des Proxy-Netzwerks NetNut unter Beteiligung von Google und FBI | Ein großer Teil der Proxy-Kapazität fällt weg |
26.08.2026 | google.com/goto-Weiterleitungen auf organischen Links offiziell bestätigt | Ziel-URLs sind im Quelltext nicht mehr direkt lesbar |
ab ca. 11.09.2026 | Laut DemandSphere die bisher aggressivste Blockade | Datenlücken bei zahlreichen Anbietern |
Ende Sept./Anfang Okt. 2026 | Plausibel aussehende, aber falsche Rankingdaten |
Auffällig ist die Reihenfolge: Erst wurde der Zugang erschwert, dann die Effizienz, dann die Lesbarkeit. Und zuletzt die Verlässlichkeit der Daten selbst.
Google-interne Sprungmarken: Die goto-Weiterleitungen
Die naheliegendste Methode, Scrapern das Leben schwer zu machen, ist inzwischen Realität. Organische Suchergebnisse verlinken nicht mehr direkt auf die Zielseite, sondern auf eine Google-interne Adresse nach dem Muster google.com/goto?url=[hash]. Erst beim Klick leitet Google auf die eigentliche URL weiter. Erste Sichtungen gab es laut PPC Land bereits im Juni 2026, am 26. August hat Google den Rollout bestätigt. Inzwischen tauchen die Weiterleitungen auch in SERP-Features auf.
Frühere Redirect-Varianten wie /url?q= waren für Tools kaum ein Problem, weil die Ziel-URL im Klartext im Parameter stand. Beim goto-Format steckt dort nur ein Hash. Er lässt sich nicht lokal entschlüsseln, und HEAD-Requests werden abgelehnt. Wer wissen will, welche Domain hinter einem Ergebnis steht, muss jede Weiterleitung einzeln auflösen.
Die Folgen für Tools, die das nicht tun, sind gravierend:
Alle Ziel-URLs lösen scheinbar auf google.com auf.
Eigene Seiten werden nicht mehr als eigene erkannt.
Share of Voice und Wettbewerbsvergleiche werden gegen falsche Domains berechnet.
Historische Zeitreihen brechen zum Stichtag ab.
Die Anbieter haben unterschiedlich reagiert. SISTRIX löst nach eigenen Angaben jeden Link mit einem zusätzlichen Server-Request auf, SerpApi meldete Anfang September eine Lösung, die wieder direkte URLs liefert. Nozzle-CEO Derek Perkins beziffert den Aufwand für ein vollständig aufgelöstes Ranking über fünf Ergebnisseiten auf 500 bis 1.000 Requests. Zur Einordnung: Bis September 2025 reichte dafür ein einziger Request mit num=100.
Offiziell begründet Google die Maßnahme allgemein mit dem Schutz vor Missbrauch. Was als Missbrauch gilt, definiert Google dabei selbst.
Data Poisoning: Wenn falsche Daten schlimmer sind als keine
Die bislang folgenreichste Eskalation ist die jüngste. Nach Angaben des Anbieters DemandSphere liefert Google seit Anfang Oktober erkannten Bots teilweise manipulierte Ergebnisseiten aus. Betroffen sind demnach rund 11 Prozent der täglich erhobenen SERPs. Nozzle kommt in einer eigenen Auswertung auf 8 Prozent. Beide Anbieter beschreiben dasselbe Muster: Zuerst kamen breite IP-Sperren und mehr CAPTCHAs, danach ausgetauschte Ergebnisse. Lücken werden dabei bevorzugt mit Social-Media- und Forenseiten gefüllt, während getrackte Domains aus den Top 10 verschwinden. Quelle: PPC Land
Google hat sich dazu bislang nicht geäußert, und beide Zahlen stammen von Anbietern mit eigenem Interesse an dem Thema. Trotzdem ist der Mechanismus der entscheidende Punkt:
Eine Blockade erzeugt eine Lücke. Der Anbieter sieht sie, kann sie kennzeichnen oder nachmessen.
Eine manipulierte SERP sieht normal aus. Sie produziert eine plausible, aber falsche Zahl.
Für die Praxis bedeutet das: Ein vermeintlicher Absturz aus den Top 10 für ein wichtiges Keyword kann eine echte Rankingveränderung sein. Oder eine Ergebnisseite, die nur ein Bot je zu Gesicht bekommen hat.
Erschwerend kommt der Zeitpunkt hinzu. Zwischen dem 24. September und dem 8. Oktober lief parallel das Google Spam Update September 2026. Laut DemandSphere ist außerdem im September der Anteil von AI Overviews bei Brand-Suchanfragen sprunghaft gestiegen, von rund 26 auf über 80 Prozent der getrackten Keywords. Echte Updates, neue SERP-Elemente und vergiftete Messdaten lassen sich in diesem Zeitraum kaum sauber voneinander trennen.
DemandSphere reagiert mit einer Funktion namens „Observability“, die neben den Rankings auch Fehler- und Sampling-Raten ausweist. Also Daten über die Qualität der Daten. Vergleichbare Transparenz bieten die meisten anderen Anbieter bislang nicht.
Die juristische Front: Google gegen SerpApi
Parallel zur Technik versucht Google, Scraping auch vor Gericht zu stoppen. Im Dezember 2025 hat Google den texanischen Anbieter SerpApi verklagt, der SERP-Daten als API an SEO-Tools, KI-Unternehmen und andere Kunden verkauft. Der Kern des Vorwurfs: SerpApi umgehe SearchGuard und damit eine technische Schutzmaßnahme im Sinne des US-Urheberrechts (DMCA). Google forderte 200 bis 2.500 US-Dollar Schadenersatz pro Umgehung. Bei nach Googles Schätzung hunderten Millionen Anfragen pro Tag eine Summe, die laut SerpApi rechnerisch die gesamte US-Wirtschaftsleistung übersteigen würde.
Die erste Runde hat Google verloren. Am 20. Juli 2026 hat das Bundesbezirksgericht in Nordkalifornien die DMCA-Klage abgewiesen. Die Begründung: Für Suchergebnisse ohne urheberrechtlich geschützte Inhalte schützt SearchGuard keinen Zugang zu einem geschützten Werk. Diesen Teil kann Google nicht erneut einklagen. Ganz gewonnen hat SerpApi allerdings nicht. Das Gericht hielt die Umgehung von SearchGuard für ausreichend dargelegt und ließ Google eine zweite Chance für lizenzierte Inhalte, etwa in Knowledge Panels.
Diese Chance hat Google genutzt. Die geänderte Klage vom 10. August stützt sich auf Lizenzvereinbarungen, unter anderem mit Reddit. SerpApi hat erneut die Abweisung beantragt. Die für den 13. Oktober angesetzte Anhörung wurde aufgehoben, das Gericht will einen neuen Termin ansetzen oder schriftlich entscheiden. Stand heute ist der Fall offen.
Unabhängig vom Ausgang ist eines klar: Kein Urteil verpflichtet Google, num=100 zurückzubringen oder seine Bot-Abwehr zu lockern. Je enger der juristische Weg wird, desto stärker dürfte Google auf Technik setzen. Die Entwicklung seit Juli spricht dafür.
Ausblick: Wie Ranktracking künftig aussehen dürfte
Ranktracking wird nicht verschwinden. Aber es wird teurer, langsamer und ungenauer. Die folgenden Punkte sind eine Einschätzung, keine Gewissheit.
Screenshot statt Quelltext? Eher nicht der entscheidende Schritt
Naheliegend wäre die Idee, Ergebnisseiten nicht mehr per Quelltext auszulesen, sondern als Screenshot zu erfassen und per KI oder OCR auszuwerten. Solange ein Snippet die Domain anzeigt, wäre die Position so theoretisch weiter ermittelbar. Allerdings löst das die aktuellen Probleme nur bedingt:
Der Browser läuft ohnehin. Seit der JavaScript-Pflicht arbeiten Scraper mit echten, gerenderten Browser-Sessions. Der fertige DOM liegt damit genauso vor wie ein Bild der Seite.
Text lässt sich kaum verstecken. Snippets clientseitig zu maskieren, etwa über Canvas-Rendering, würde Screenreader, Browser-Übersetzung und die Suche auf der Seite brechen. Barrierefreiheit ist hier eine harte Grenze, technisch wie regulatorisch.
Gegen manipulierte SERPs hilft kein Bild. Wer als Bot erkannt wird, bekommt die falsche Seite, ob er sie nun parst oder fotografiert.
Die eigentliche Hürde liegt also nicht beim Auslesen, sondern beim Zugang: unerkannt bleiben, Challenges lösen, glaubwürdige IP-Adressen nutzen. Genau dort setzt Google an, inklusive des Vorgehens gegen Proxy-Netzwerke wie NetNut.
Was sich konkret ändern dürfte
Höhere Preise: Jede Eskalation hat die Kosten pro Keyword vervielfacht. Diese Kosten landen früher oder später bei den Kunden.
Sampling statt Vollerhebung: Weniger Keywords, seltener gemessen, Tiefenabfragen nur noch stichprobenartig. DemandSphere bestätigt bereits, Unterseiten teilweise nur noch per Sampling zu erfassen.
Qualitätskennzahlen als Standard: Fehler- und Sampling-Raten dürften zum Pflichtbestandteil seriöser Tools werden.
Konsolidierung: Den Aufwand werden nicht alle Anbieter dauerhaft stemmen. Kleinere Tools ohne eigene Infrastruktur dürften es besonders schwer haben.
Bemerkenswert ist, wen Google eigentlich im Visier haben dürfte. DemandSphere-Gründer Ray Grieselhuber und Barry Schwartz von Search Engine Roundtable vermuten beide, dass es vor allem um KI-Unternehmen geht, die Googles Ergebnisse für ihre eigenen Antworten nutzen. SEO-Tools wären demnach eher Kollateralschaden. Bestätigt hat Google das nicht.
Was bleibt: Die Search Console als Fallback
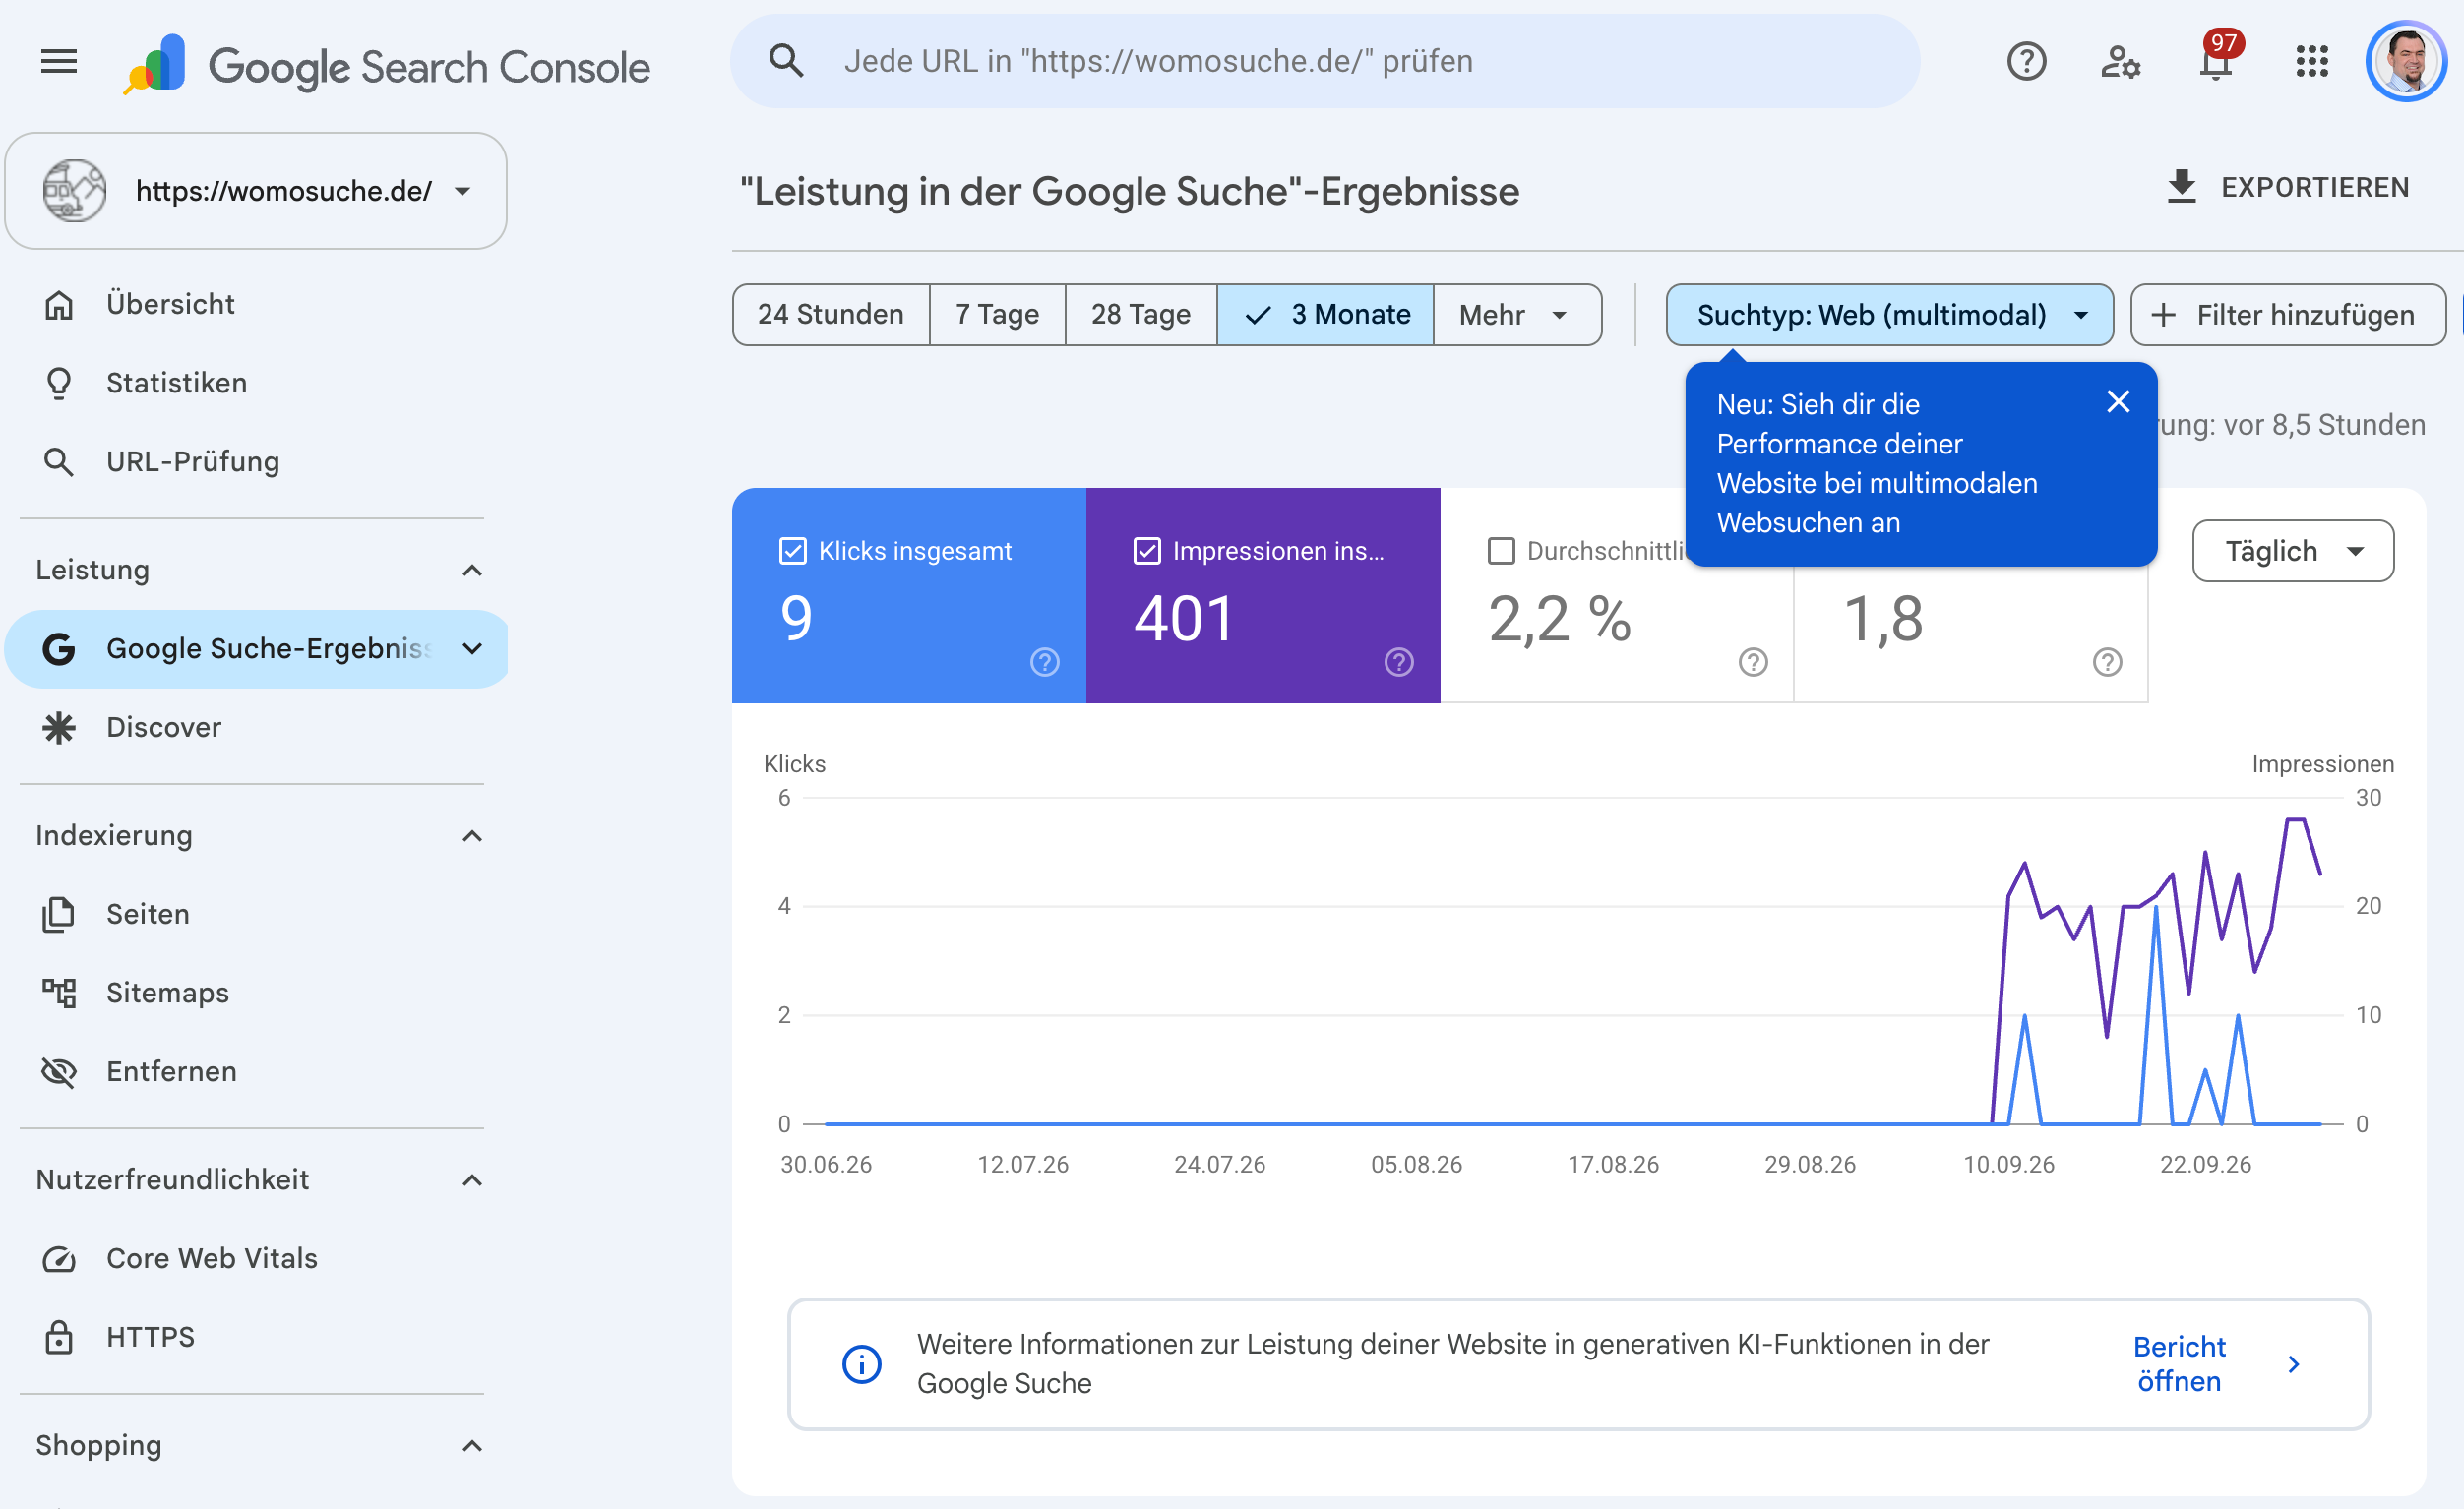
Wenn externe Daten unzuverlässiger werden, rückt die Google Search Console in den Mittelpunkt. Sie hat einen großen Vorteil: Sie basiert auf echten Nutzern statt auf Snapshots aus einem Rechenzentrum. Manipulierte SERPs für Bots tauchen dort nicht auf. Im Gegenteil: Mit dem Ende von num=100 sind dort sogar viele Bot-Impressionen verschwunden. Viele Websites sahen ab Mitte September 2025 weniger Desktop-Impressionen bei gleichzeitig besserer durchschnittlicher Position.
Die bekannten Schwächen bleiben aber bestehen:
Nur die eigene Domain: Wettbewerber, Sichtbarkeitsvergleiche und Marktanalysen sind nicht abbildbar. Das ist der eigentliche Verlust, wenn Ranktracking wegbricht.
Durchschnittswerte statt Positionen: Die durchschnittliche Position ist über alle Impressionen gewichtet, inklusive SERP-Features, Standorte und Geräte. Eine konkrete Position an einem konkreten Tag ist das nicht.
Verzögerung: Die Daten kommen mit einigen Tagen Latenz, für schnelle Reaktionen auf Updates zu spät.
Lücken: Anonymisierte Suchanfragen fehlen, die Oberfläche zeigt nur einen Ausschnitt der Daten. API und Bulk-Export nach BigQuery helfen beim Umfang, nicht bei der Anonymisierung.
KI-Suche als Blackbox: Der im August eingeführte Bericht zur KI-Suche zeigt laut PPC Land Impressionen, aber weder Klicks noch Suchanfragen.
Die Search Console ersetzt Ranktracking also nicht. Sie ist die verlässlichste Quelle für die eigene Performance und der wichtigste Abgleich, um externe Daten auf Plausibilität zu prüfen.
Was SEOs jetzt tun sollten
Den Zeitraum markieren: Rankingdaten ab Mitte September 2026 in Reports und Dashboards annotieren. Veränderungen in diesem Fenster nur mit Gegenprüfung bewerten.
Keine Entscheidungen auf Basis einzelner Messpunkte: Ein plötzlicher Absturz, der nach wenigen Tagen wieder verschwindet, ist im Zweifel ein Messproblem. Erst Trends über mehrere Tage zählen.
Gegen die Search Console abgleichen: Bewegen sich Klicks und Impressionen in der GSC nicht, ist ein Rankingverlust im Tool mit Vorsicht zu genießen.
Beim Tool-Anbieter nachfragen: Wie werden goto-Links aufgelöst? Gibt es Fehler- und Sampling-Raten? Welche Tage sind betroffen? Wer hier keine Antwort bekommt, sollte das in die Bewertung der Daten einbeziehen.
Keyword-Sets verschlanken: Weniger, dafür geschäftsrelevante Keywords zu tracken, dämpft steigende Kosten und erhöht die Aussagekraft.
Eigene Datenbasis aufbauen: Search-Console-Daten per API oder BigQuery-Export dauerhaft speichern. Die Oberfläche zeigt nur 16 Monate, der eigene Speicher alles.
Ergebniskennzahlen stärker gewichten: Klicks, Leads und Umsatz aus organischer Suche sagen mehr über den Erfolg als eine einzelne Position, zumal eine Top-Position unter einer AI Overview nicht mehr dieselbe ist wie früher.
Fazit
Google macht SERP-Scraping Schritt für Schritt teurer und unzuverlässiger. Die JavaScript-Pflicht, das Ende von num=100 und die goto-Weiterleitungen haben die Kosten pro Keyword vervielfacht. Mit manipulierten Ergebnisseiten für erkannte Bots ist eine neue Qualität erreicht: Das Problem sind nicht mehr nur fehlende, sondern falsche Daten. Juristisch hat Google zwar die erste Runde gegen SerpApi verloren. An der technischen Abwehr ändert das aber nichts.
Ranktracking wird es weiter geben, nur mit höheren Preisen, mehr Sampling und größeren Unsicherheiten. Die Search Console wird als Kontrollinstanz wichtiger, kann den Blick auf den Wettbewerb aber nicht ersetzen. Für SEOs heißt das: Daten kritischer lesen, Quellen kombinieren und vom Tool-Anbieter Transparenz über die Datenqualität einfordern.
Quellen
PPC Land: Google returns wrong results on 11% of DemandSphere's daily rank checks (13.10.2026)
PPC Land: Explaining DMCA – Stand Google vs. SerpApi (14.10.2026)
Search Engine Land: Google loses key DMCA claims against SerpApi (22.07.2026)
SerpApi: Google tried again. We're moving to dismiss a second time
zeo.org: The Impact of &num=100 Parameter Removal on SEO Reporting
Octoparse: Google official search API – Custom Search JSON API closing